Universitatea Tehnică din Cluj-Napoca / Hub Român de Inteligență Artificială Cofinanțat de Uniunea Europeană · MySMIS 334906
Voci sintetice HRIA
Proiect HRIA · Departamentul de Telecomunicații UTCN

Sinteză de voce românească, măsurată

Cinci arhitecturi TTS antrenate pe corpusuri românești, un corpus emoțional propriu cu doi vorbitori și un frontend de preprocesare a textului — cu perechile voce naturală / voce sintetizată care stau la baza fiecărei cifre de mai jos.

Oscar Gal, Mircea Giurgiu · Departamentul de Telecomunicații, Universitatea Tehnică din Cluj-Napoca. Toate mostrele audio de pe pagină sunt ieșiri reale ale modelelor, iar valorile numerice provin din fișierele de evaluare ale experimentelor, nu din estimări.

Două articole publicate · un manuscris în lucru

Trei lucrări, un protocol de evaluare

Toate trei folosesc exclusiv metrici obiective, reproductibile — alegere deliberată pentru o limbă cu resurse reduse, unde testele subiective la scară nu sunt fezabile. A treia lucrare este un manuscris în lucru, nepublicat încă; este marcată ca atare.

Tabelul principal din benchmark-ul MARA

Cinci enunțuri reprezentative × patru arhitecturi. Valoarea cea mai bună de pe fiecare enunț este marcată.

Raportare la sistemele de referință anterioare

Tabel reprodus din articol ca atare: aceleași modele, evaluate cu sistemele de referință din literatură în loc de înregistrarea naturală, pentru continuitate cu rezultatele mai vechi ale grupului.

Manuscris în lucru — F5-TTS față de VITS, cu ASR în protocol

Cel mai riguros protocol de până acum: 330 de perechi sinteză–referință, text identic pentru ambele arhitecturi, același frontend de preprocesare, aceleași referințe naturale și un decodor ASR înghețat care adaugă WER și CER celor cinci metrici de semnal. Rezultatele de mai jos sunt preliminare — lucrarea nu este încă publicată.

Corpus MARA · text identic · 62 de fraze evaluate

Aceeași frază, prin patru sisteme

Fiecare bloc de mai jos pornește de la înregistrarea naturală a aceleiași propoziții din „Mara” lui Slavici, urmată de sinteza fiecărui sistem. Metricile din dreapta sunt calculate față de acea înregistrare, cu aliniere DTW. Pe ultimele două propoziții apare și F5-TTS, singurele din setul lui care coincid cu acest corpus de test.
Cum se citesc metricile. MCD (distorsiune cepstrală mel, dB, ↓) și F0 RMSE / corelația F0 sunt aliniate prin DTW și sunt metricile de încredere pentru TTS. STOI și PESQ presupun aliniere la nivel de eșantion, pe care vocea sintetizată nu o are niciodată — de aceea rămân aproape de valoarea lor minimă și sunt raportate doar informativ. Nicăieri pe această pagină nu trebuie citite ca o măsură de calitate percepută.
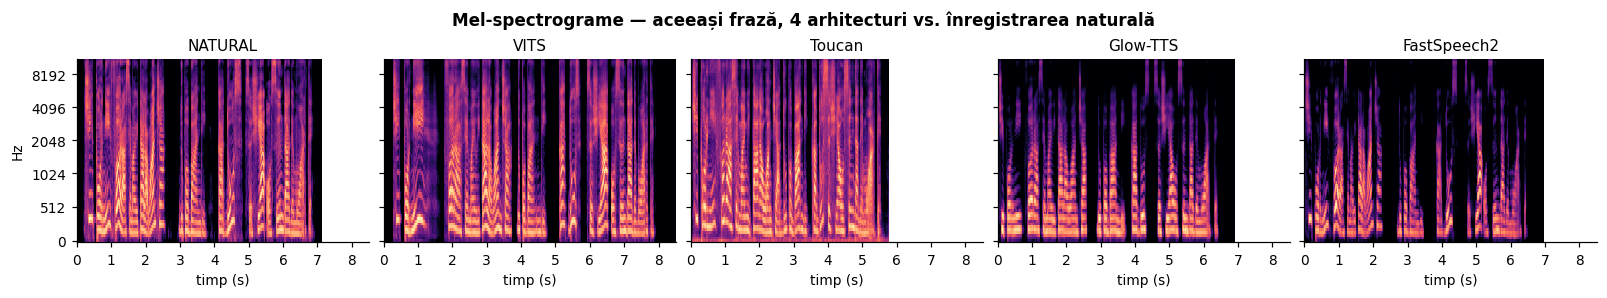
Mel-spectrograme pentru natural și patru sisteme
Mel-spectrograme, aceeași frază. Toucan comprimă enunțul (5,6 s față de 6,9 s natural) și păstrează structura armonică cea mai netedă; VITS îl dilată (8,2 s) dar reține cel mai bine detaliile de bandă înaltă; Glow-TTS și FastSpeech2 arată tranziții mai abrupte între segmente, vizibile ca discontinuități verticale.
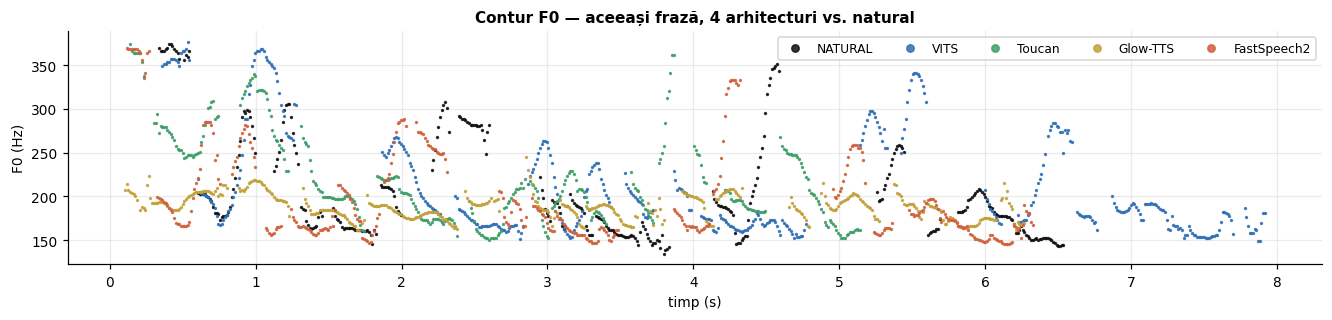
Contur F0 pentru natural și patru sisteme
Conturul F0. VITS urmărește cel mai fidel forma melodică a originalului (corelație medie 0,68 pe cele 62 de fraze); Toucan obține cea mai bună fidelitate spectrală, dar cea mai mare eroare de pitch (61,1 Hz RMSE) — un compromis vizibil direct în aceste curbe.

VITS față de F5-TTS pe aceeași frază

F5-TTS nu este antrenat pe MARA: clonează vocea dintr-un singur prompt de referință de câteva secunde. Comparația arată ce se câștigă și ce se pierde față de un model antrenat dedicat.
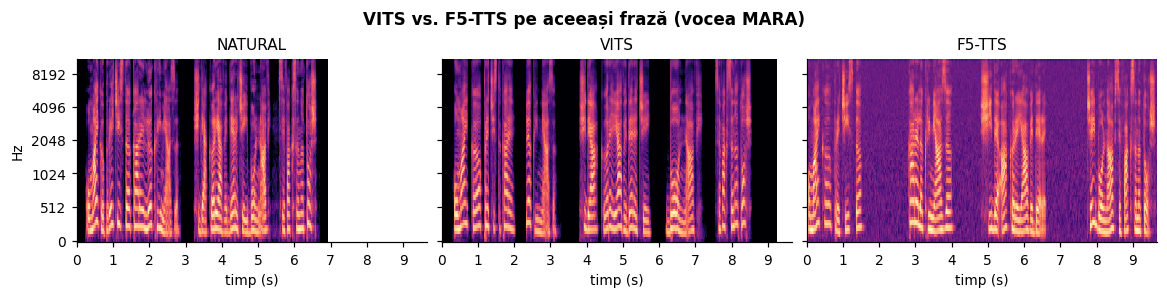
Mel-spectrograme natural, VITS, F5-TTS
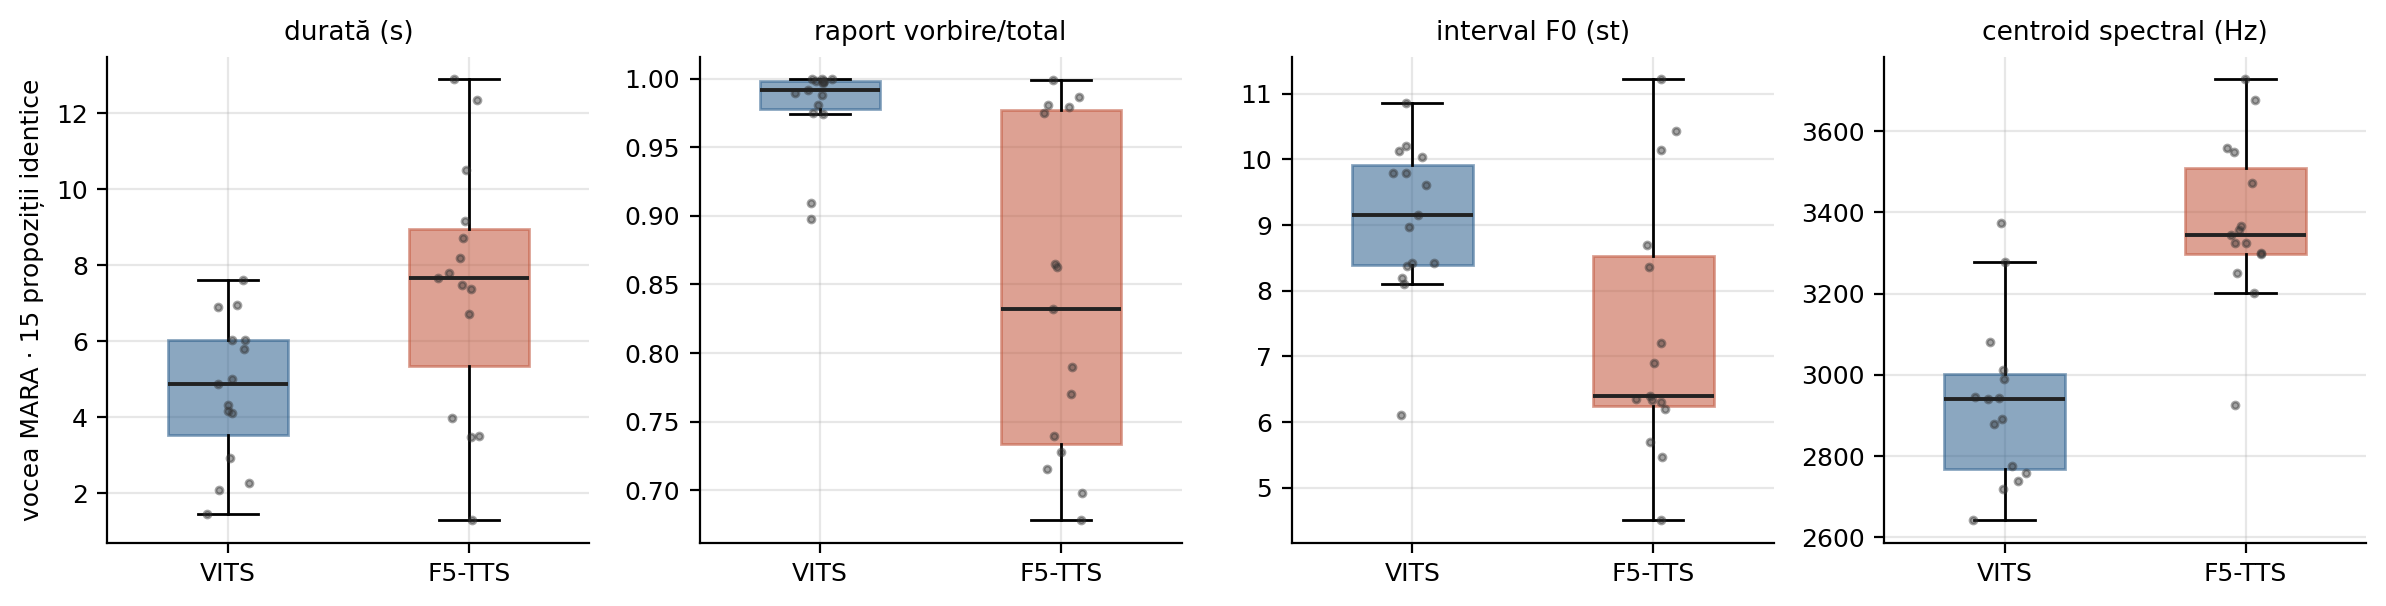
Model dedicat vs. clonare zero-shot. F5-TTS reconstruiește o voce recognoscibilă fără antrenare pe corpus, dar cu un centroid spectral mai ridicat și o durată mult mai variabilă.
Boxploturi VITS versus F5-TTS
15 propoziții identice, vocea MARA. VITS produce enunțuri compacte și aproape integral vocale (raport vorbire/total ≈ 0,99), cu un interval F0 larg. F5-TTS generează enunțuri mai lungi și mai variabile, cu pauze și artefacte care coboară raportul vorbire/total până la 0,68, și cu un centroid spectral sistematic mai înalt.
Efectul tokenilor paralingvistici și separarea vorbitorilor
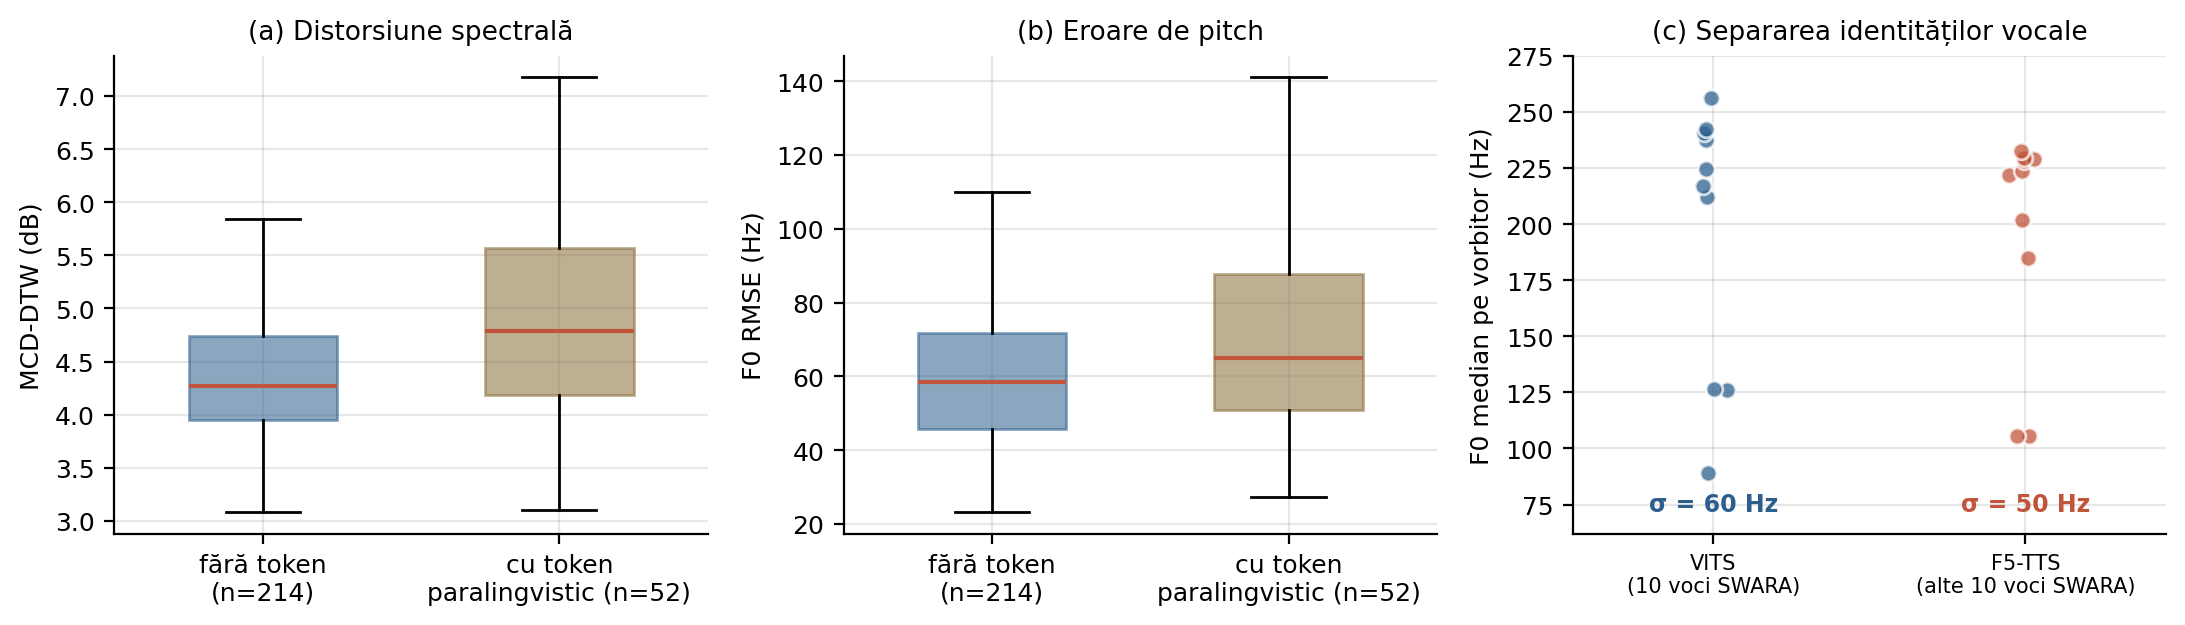
Ce costă tokenii paralingvistici. Enunțurile care conțin o etichetă de tip <oftat> sau <respirație> se sintetizează cu MCD și eroare de pitch măsurabil mai mari (n = 52 față de n = 214). În dreapta: ambele sisteme separă corect identitățile vocale, cu o dispersie a F0 median comparabilă.
62 de fraze × 4 arhitecturi · n = 248 de perechi

Rezultate obiective pe toate arhitecturile

Experimentul pe entități numite evaluează fiecare sistem pe aceleași 62 de propoziții din MARA, grupate după tipul de entitate pe care îl conțin: persoane, locuri, organizații și diverse. Este cel mai mare set de perechi comparabile din proiect.
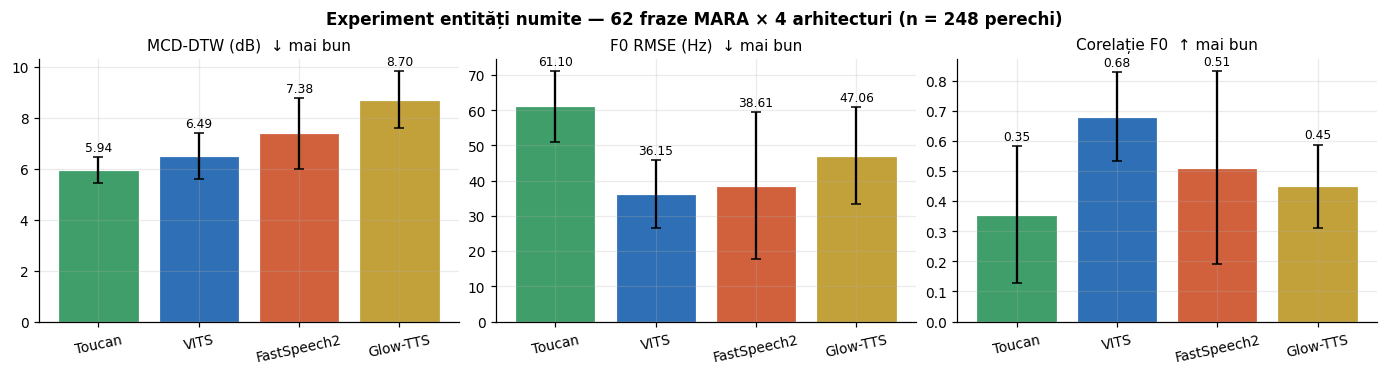
Comparație MCD, F0 RMSE și corelație F0 pe patru sisteme
Nu există un câștigător unic. Toucan conduce clar la distorsiune spectrală, VITS la acuratețea prozodiei. Ordinea se inversează complet între prima și a treia diagramă — motiv pentru care un singur număr nu poate descrie calitatea unui sistem TTS.
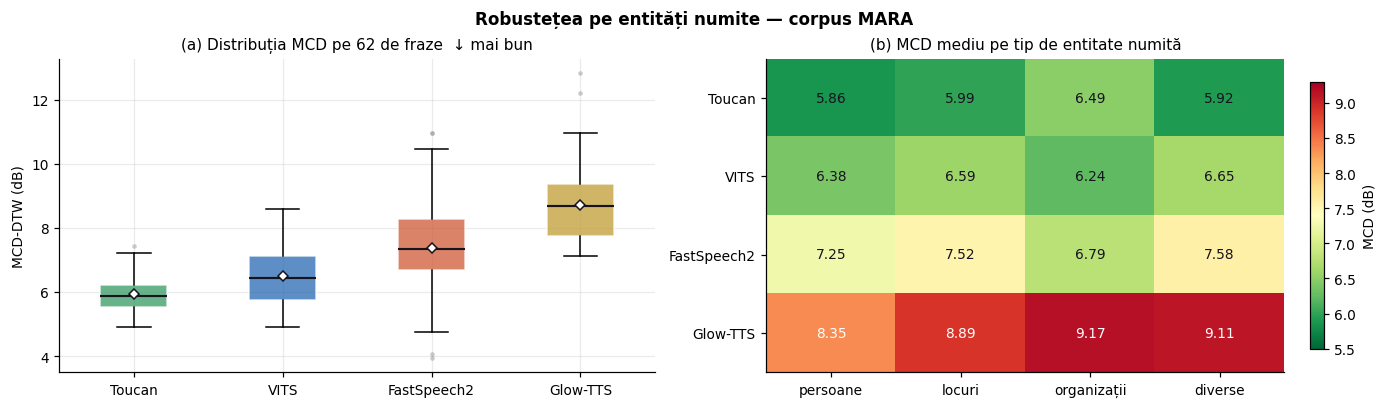
Distribuția MCD și harta pe categorii de entități
Distribuție și robustețe. Toucan are și cea mai strânsă distribuție (σ = 0,52 dB față de 1,13 dB la Glow-TTS), adică cel mai previzibil comportament de la o frază la alta. Pe categorii, diferențele sunt mici: niciun sistem nu se prăbușește pe un anumit tip de entitate numită.

F5-TTS pe vocea emoțională, 1.384 de perechi

Cel mai mare set de evaluare al proiectului: fiecare clip din corpusul Catalina resintetizat și comparat cu originalul.
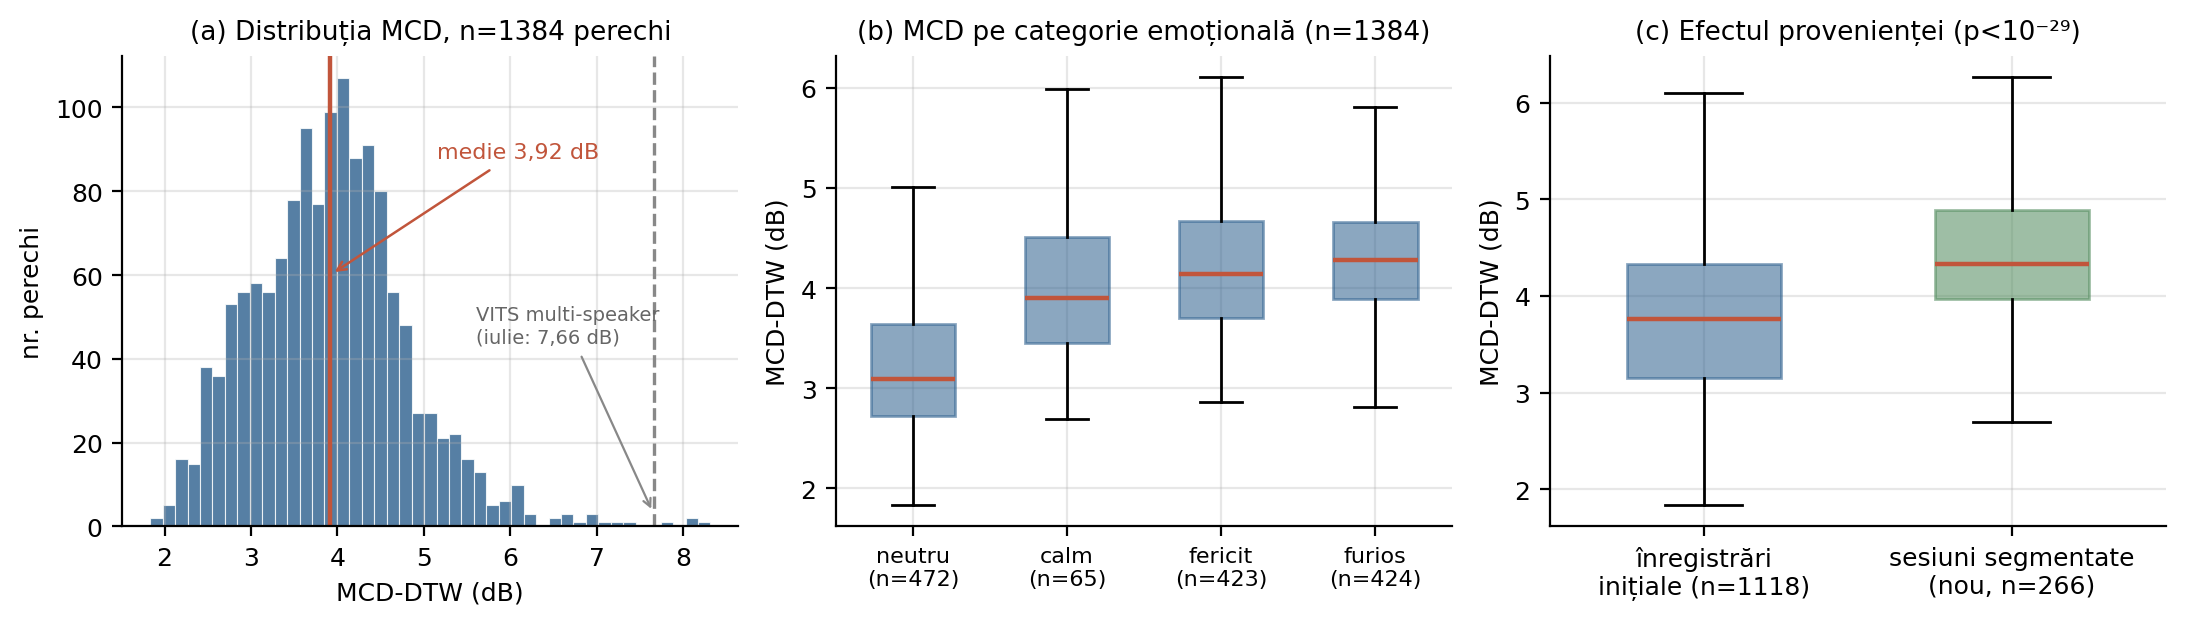
Distribuția MCD pentru F5 pe corpusul Catalina
MCD mediu 3,92 dB pe 1.384 de perechi — sub pragul obișnuit de 4 dB și mult mai bun decât modelul VITS multi-locutor (7,66 dB), care însă rezolvă o problemă diferită. Enunțurile neutre se reconstruiesc cel mai bine; furia și bucuria costă în medie peste 1 dB în plus. Panoul (c) arată un efect de proveniență semnificativ (p < 10⁻²⁹): sesiunile segmentate automat sunt sistematic mai greu de reconstruit decât înregistrările inițiale.
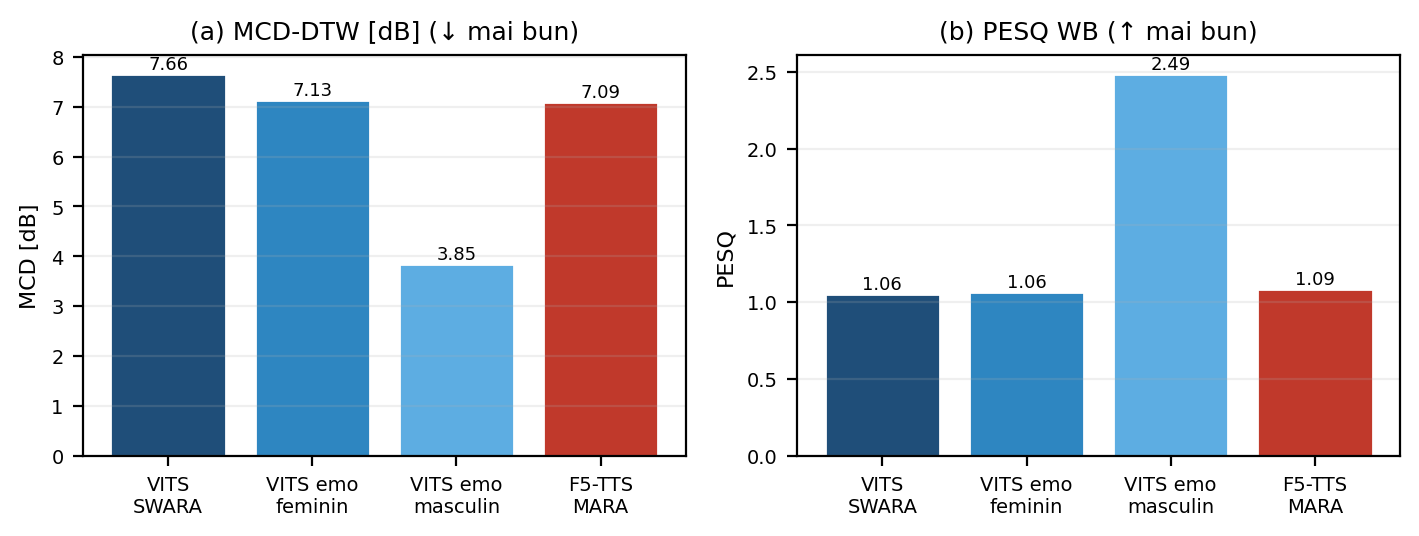
Comparație MCD și PESQ pe patru configurații
Patru configurații, două metrici. Fine-tune-ul emoțional masculin atinge cel mai mic MCD din proiect, 3,85 dB — un model antrenat pe o singură voce reconstruiește acea voce mult mai exact decât un model multi-locutor. Valoarea PESQ de 2,49 din panoul (b) este singura care iese din zona de saturație, dar provine dintr-un set de doar trei perechi cu durate foarte diferite de original și nu trebuie citită ca o calitate perceptuală superioară.
SWARA · multi-locutor

Identități vocale multiple

Un singur model VITS antrenat pe corpusul multi-locutor SWARA, plus clonarea zero-shot cu F5-TTS. Fiecare pereche de mai jos conține înregistrarea originală a vorbitorului și reconstrucția modelului pentru exact același text.

VITS multi-locutor — reconstrucție pereche

Cele cinci perechi cu cea mai bună reconstrucție din setul de evaluare.

F5-TTS — zece voci, o singură frază, fără antrenare
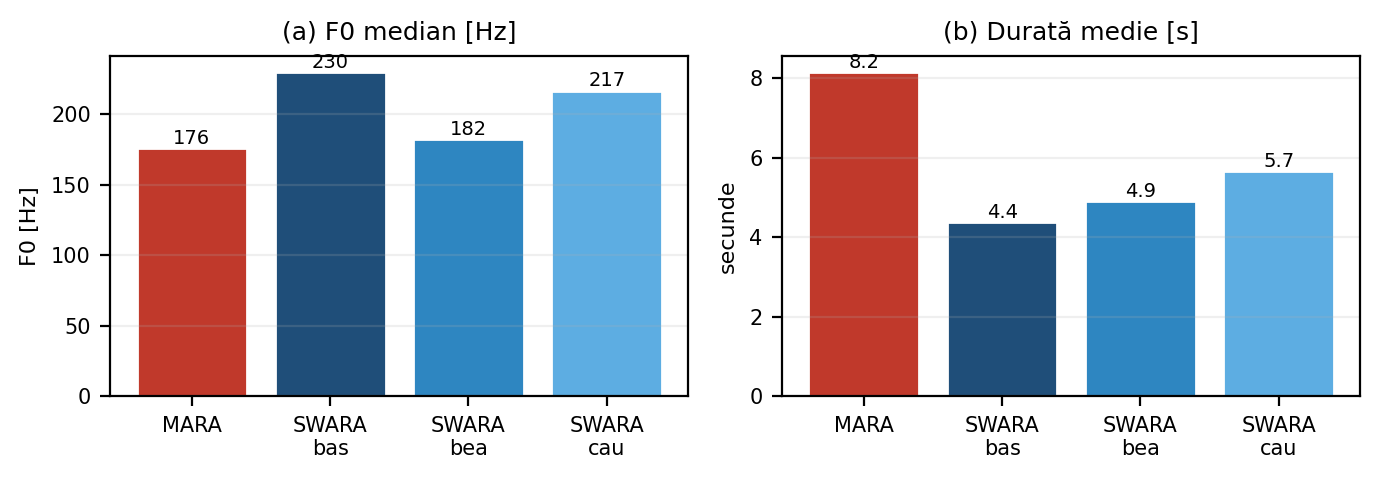
F0 median și durată medie pe patru voci
Vocile rămân distincte. F0 median separă clar vocile clonate (176–230 Hz), iar durata medie variază puternic cu prompt-ul de referință — al doilea fiind exact punctul slab al abordării zero-shot.
Corpus propriu · 2 vorbitori · 2.828 de clipuri

Corpusul emoțional și ce se poate sintetiza din el

Două corpusuri monolocutor înregistrate și curățate în cadrul proiectului, cu aceeași schemă de etichetare: neutru, fericit, furios, calm. Pe ele au fost construite două fine-tune-uri VITS și experimentul de transfer de emoție cu F5-TTS.
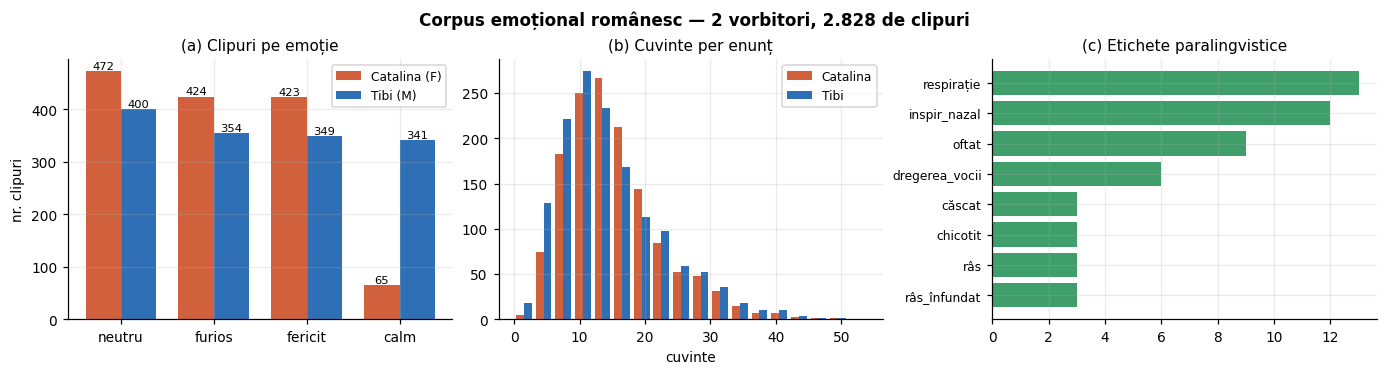
Statistici ale corpusului emoțional
Corpusul, în cifre. Catalina este dezechilibrat — 65 de clipuri calm față de 472 neutru — și acest dezechilibru se vede direct în calitatea sintezei pentru acea emoție. Tibi este aproape echilibrat. Panoul (c) arată etichetele paralingvistice păstrate în transcrieri: respirație, oftat, dregerea vocii, râs.

Exemple din corpus, pe emoții — voce feminină

Stânga: înregistrarea originală. Dreapta: reconstrucția modelului VITS fine-tune-at pe aceeași voce.

Exemple din corpus, pe emoții — voce masculină

Același protocol. Chipul durată compară secundele efectiv rostite: sinteza nu reproduce durata originalului, ci o rescrie — de la 0,6× pe enunțul furios până la 3,1× pe cel neutru. MCD și F₀ rămân valabile pentru că sunt aliniate prin DTW.
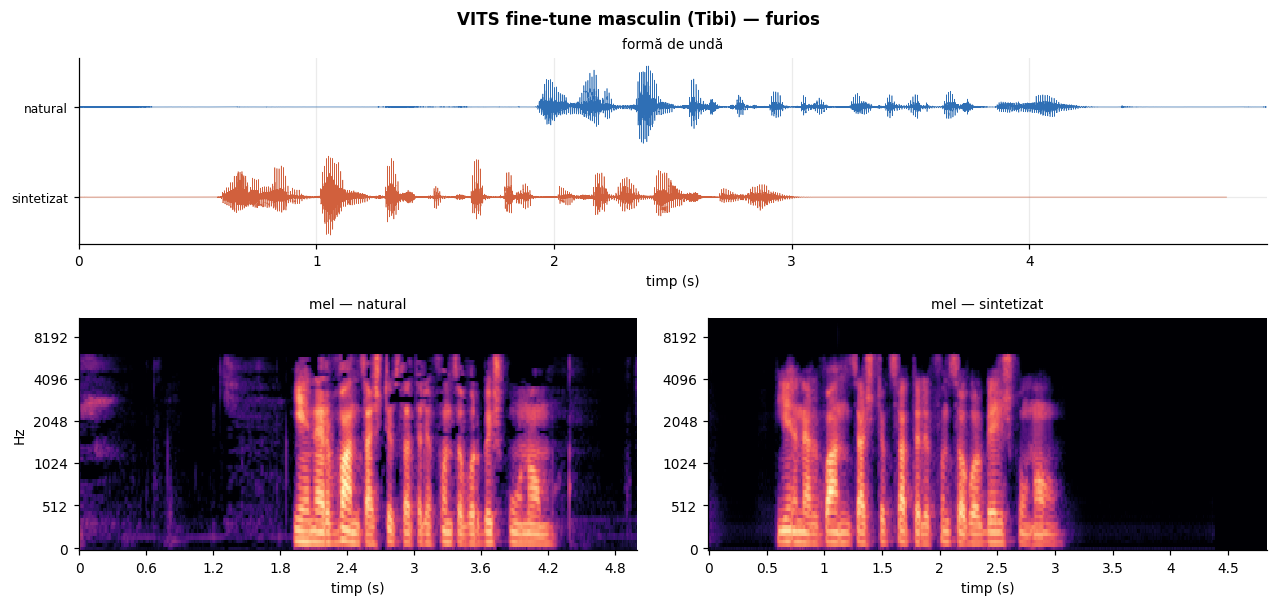
Comparație natural / sintetizat pentru vocea masculină, furios
Cea mai mică eroare de pitch din proiect: 6,3 Hz. Sinteza este mai compactă și mai curată decât înregistrarea, care conține aproape două secunde de zgomot de fond înainte de rostire — vizibile în mel-ul din stânga, sub 1 kHz. Aliniate prin DTW, MCD este 4,45 dB. Duratele însă nu coincid (2,5 s rostite sintetizat față de 4,3 s natural), deci PESQ nu spune nimic despre această pereche.

Sinteză liberă pe text nou, pe fiecare emoție

Text care nu apare în corpus, sintetizat cu modelele fine-tune-ate. Nu există referință naturală — aici se aude ce a învățat efectiv modelul despre fiecare stil.
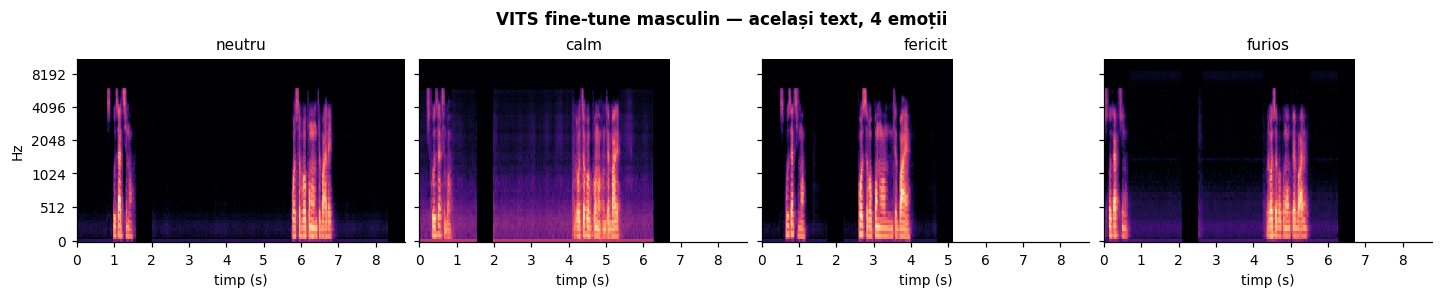
Mel-spectrograme pentru patru emoții, voce masculină
Același text, patru emoții. Diferențele de durată și de densitate energetică sunt vizibile direct: furia comprimă enunțul și îi ridică energia în banda medie, calmul îl dilată.
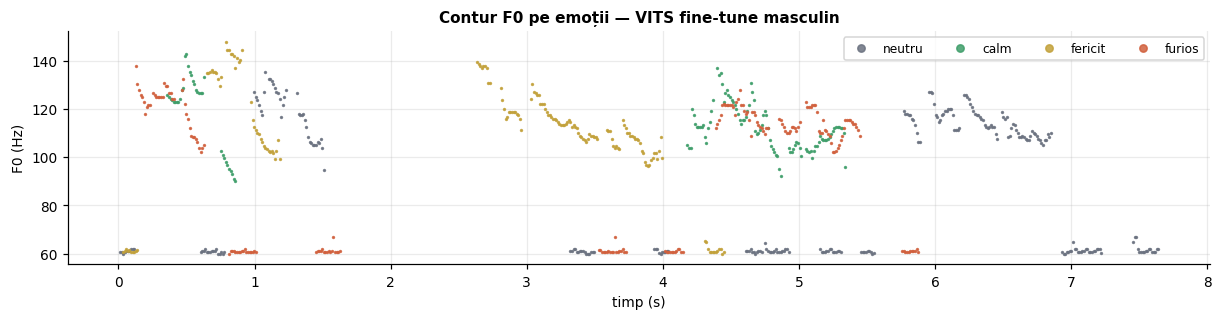
Contururi F0 pentru patru emoții
Registrul F0 pe emoții. Modelul deplasează registrul consistent, nu doar volumul — semnul că eticheta de emoție a fost învățată ca o condiționare reală, nu ignorată.

Transfer de emoție cu F5-TTS, fără fine-tune

Aici emoția nu vine dintr-o etichetă, ci dintr-un singur clip de referință de câteva secunde. Ascultați întâi referința, apoi sinteza pe text complet diferit.
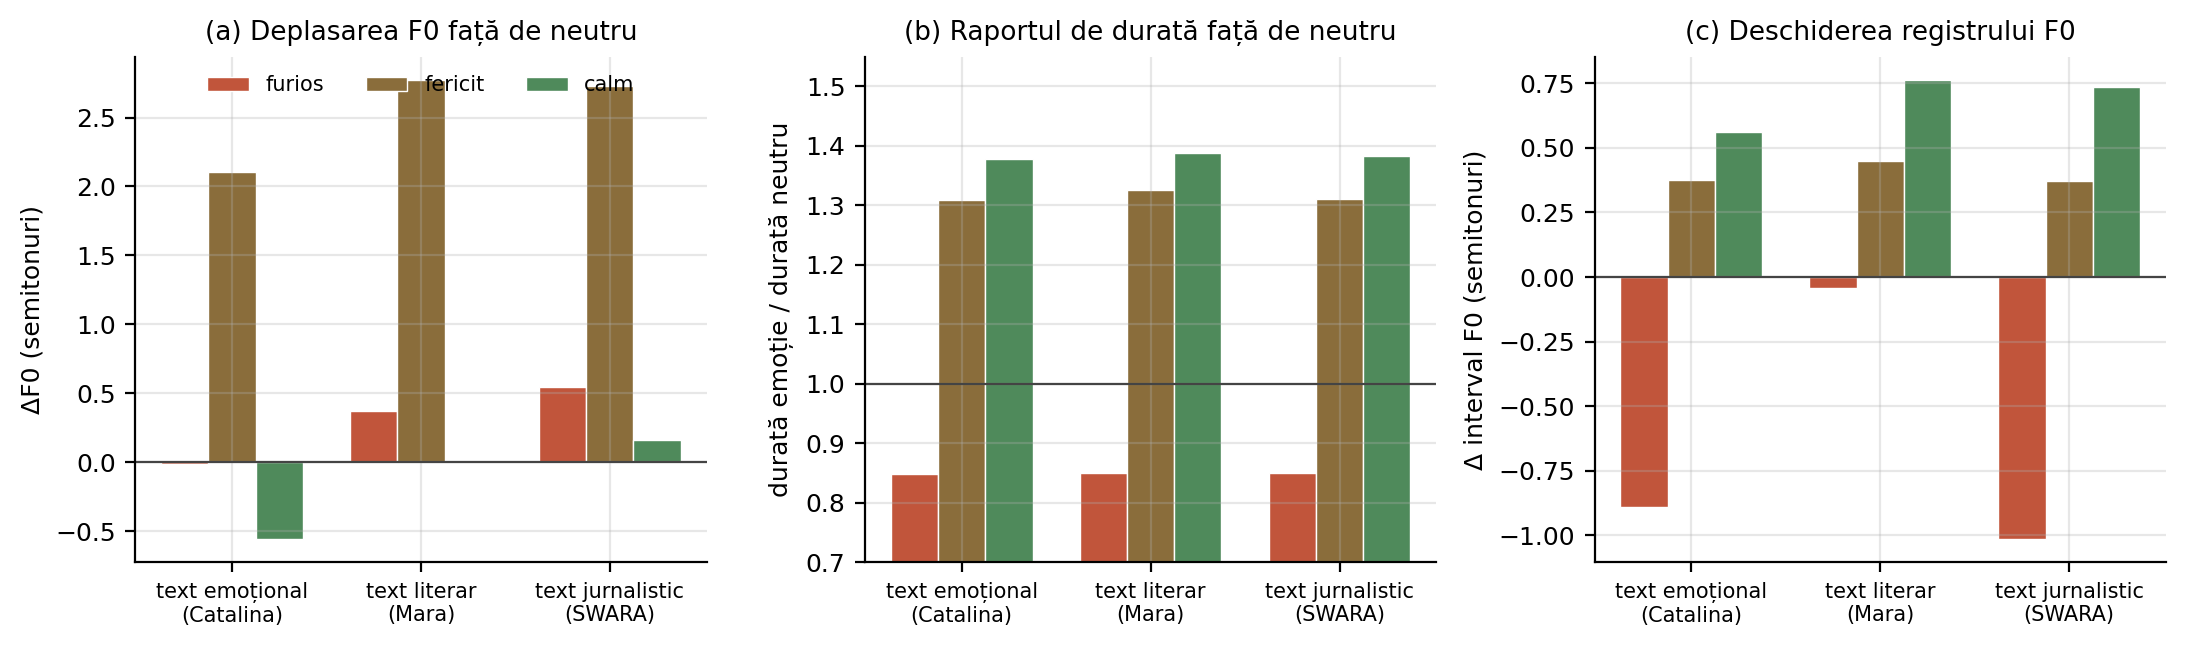
Măsurători ale transferului de emoție pe trei domenii de text
Transferul se măsoară, și e consistent între domenii. Față de neutru, fericit ridică F0 cu 2,1–2,7 semitonuri și dilată durata cu ~30 %, furios comprimă durata cu ~15 % și îngustează registrul, iar calm dilată cel mai mult. Efectul se reproduce aproape identic pe text emoțional, literar și jurnalistic — deci provine din prompt, nu din conținutul frazei.
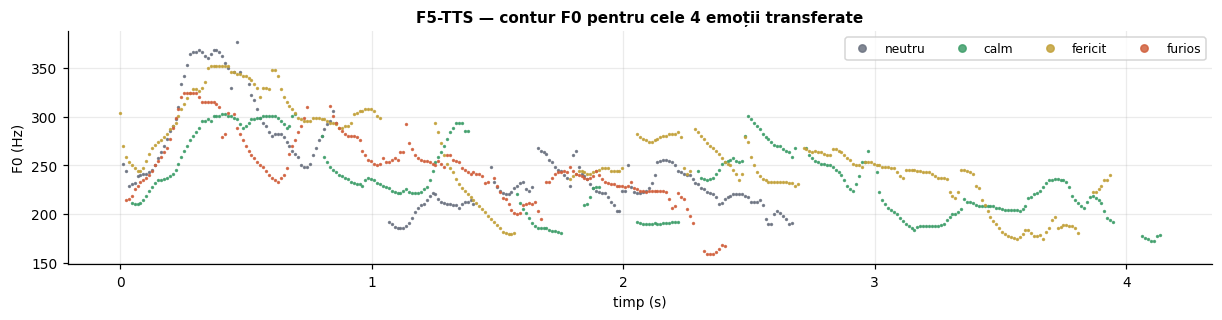
Contur F0 pentru patru emoții transferate
Aceleași patru emoții, măsurate direct pe semnal. Conturul F0 al sintezei pentru un text identic, cu patru prompturi de referință diferite.
Frontend de text · rulează local, fără servicii externe

Preprocesarea textului românesc

Un pipeline separat de modelul acustic, care transformă text brut în reprezentarea de care are nevoie un sistem TTS: text normalizat, analiză lingvistică, fonetizare IPA cu accent lexical, emoție, focus și valori de control prozodic. Tot ce urmează este ieșire reală a pipeline-ului, nu ilustrație.

1 · Normalizare — fiecare modificare este trasată

Numere, date, ore, procente, monede, unități și abrevieri sunt expandate în forma rostită, determinist, fără pierderea diacriticelor.

2 · Fonetizare, silabificare și accent lexical

Cascadă: dicționar de excepții al proiectului → eSpeak IPA → regulă grafemică marcată ca fallback. Fiecare simbol este validat față de inventarul fonetic canonic al limbii.

3 · Emoție, intensitate, valență și activare

Clasificator XLM-RoBERTa multilingv rulat local. Șase etichete plus unspecified pentru cazurile ambigue sau cu încredere scăzută. Toate valorile de mai jos sunt predicții reale pe propozițiile afișate.

4 · Focus — care cuvânt poartă accentul frazei

Scor continuu per token, separat de accentul lexical: accentul lexical spune ce silabă dintr-un cuvânt, focusul spune ce cuvânt din propoziție.

5 · Prozodie și tokeni de control

Punctuația, sintaxa, emoția și focusul devin valori de control independente de model, limitate la intervale sigure, apoi tokeni discreți pe care un model TTS îi poate consuma direct.

6 · Netezire contextuală între propoziții

Emoția fiecărei propoziții este echilibrată cu cea precedentă, fără a suprascrie vreodată predicția locală — ambele rămân în rezultat.

VITS · 1000 de epoci · 3 × GPU · fp16

Cum sună antrenarea, pas cu pas

Aceeași propoziție sintetizată cu checkpoint-uri succesive ale modelului VITS pe MARA. De la zgomot structurat la voce inteligibilă, apoi la prozodie — se aude unde se face fiecare salt.
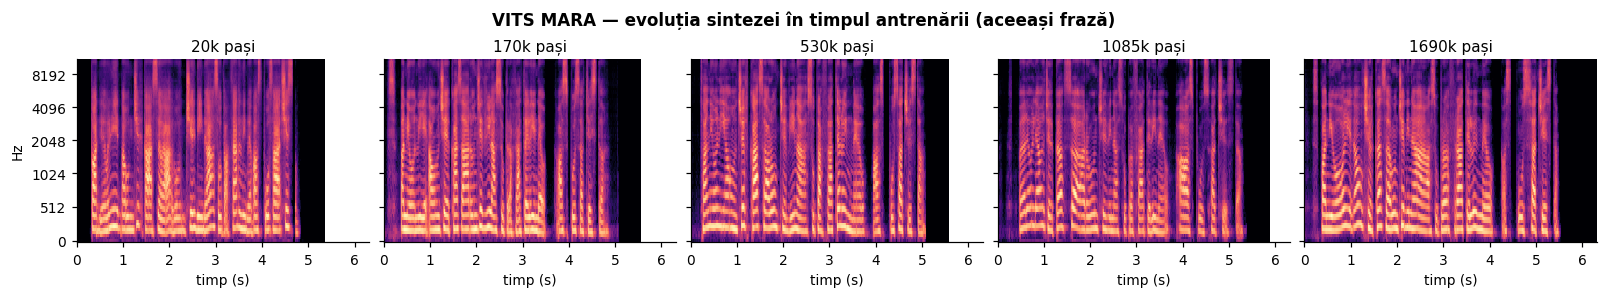
Mel-spectrograme la cinci momente din antrenare
Aceeași frază, cinci checkpoint-uri. La 20k pași structura armonică este deja prezentă, dar tranzițiile sunt spălate; între 170k și 530k apar formanții net delimitați; după 1M pași câștigul se mută aproape integral în prozodie și în terminațiile de enunț.

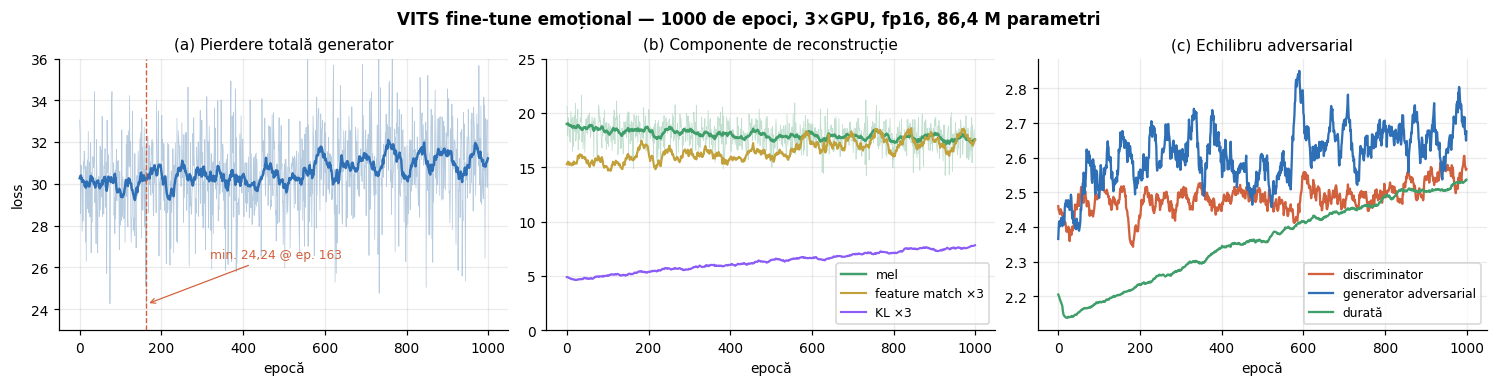
Curbele fine-tune-ului emoțional

Curbe de învățare pe trei panouri
Un fine-tune, nu o antrenare de la zero. Pierderea totală pornește deja din apropierea platoului și nu mai scade — câștigul este în adaptarea vocii, nu în minimizarea pierderii. Panoul (b) arată componenta mel coborând lent, în timp ce termenul KL crește constant, iar (c) arată pierderea adversarială a generatorului derivând în sus: semnătura clasică a unei antrenări GAN prelungite. De aceea selecția checkpoint-ului se face pe pierderea mel de validare, nu pe pierderea totală.
Cazuri de eșec, cu material audio

Ce nu funcționează

Cazurile problematice sunt la fel de informative ca rezultatele bune și sunt reproductibile din aceleași fișiere. Fiecare exemplu de mai jos poate fi ascultat.